یک عامل برنامهنویس که وظایف شبیهسازیشده میسازد، در کنار یک مدل ویدئویی که تصاویر واقعنما تولید میکند، میتواند نیاز به نمایشهای عملی فیزیکی برای آموزش رباتها را کاهش دهد. پژوهشگران وابسته به دانشگاه پکن و انویدیا گزارش میدهند که سامانه PyRUA-DataFarm آنها دادههای آموزشیای تولید کرده که عملکرد خوبی در پنج وظیفه روی ربات واقعی داشتهاند. این پژوهش در ۳ نوامبر ۲۰۲۶ در arXiv منتشر شد؛ داوری علمی آن تأیید نشده و بازتولید مستقلی از نتایج ارائه نشده است.
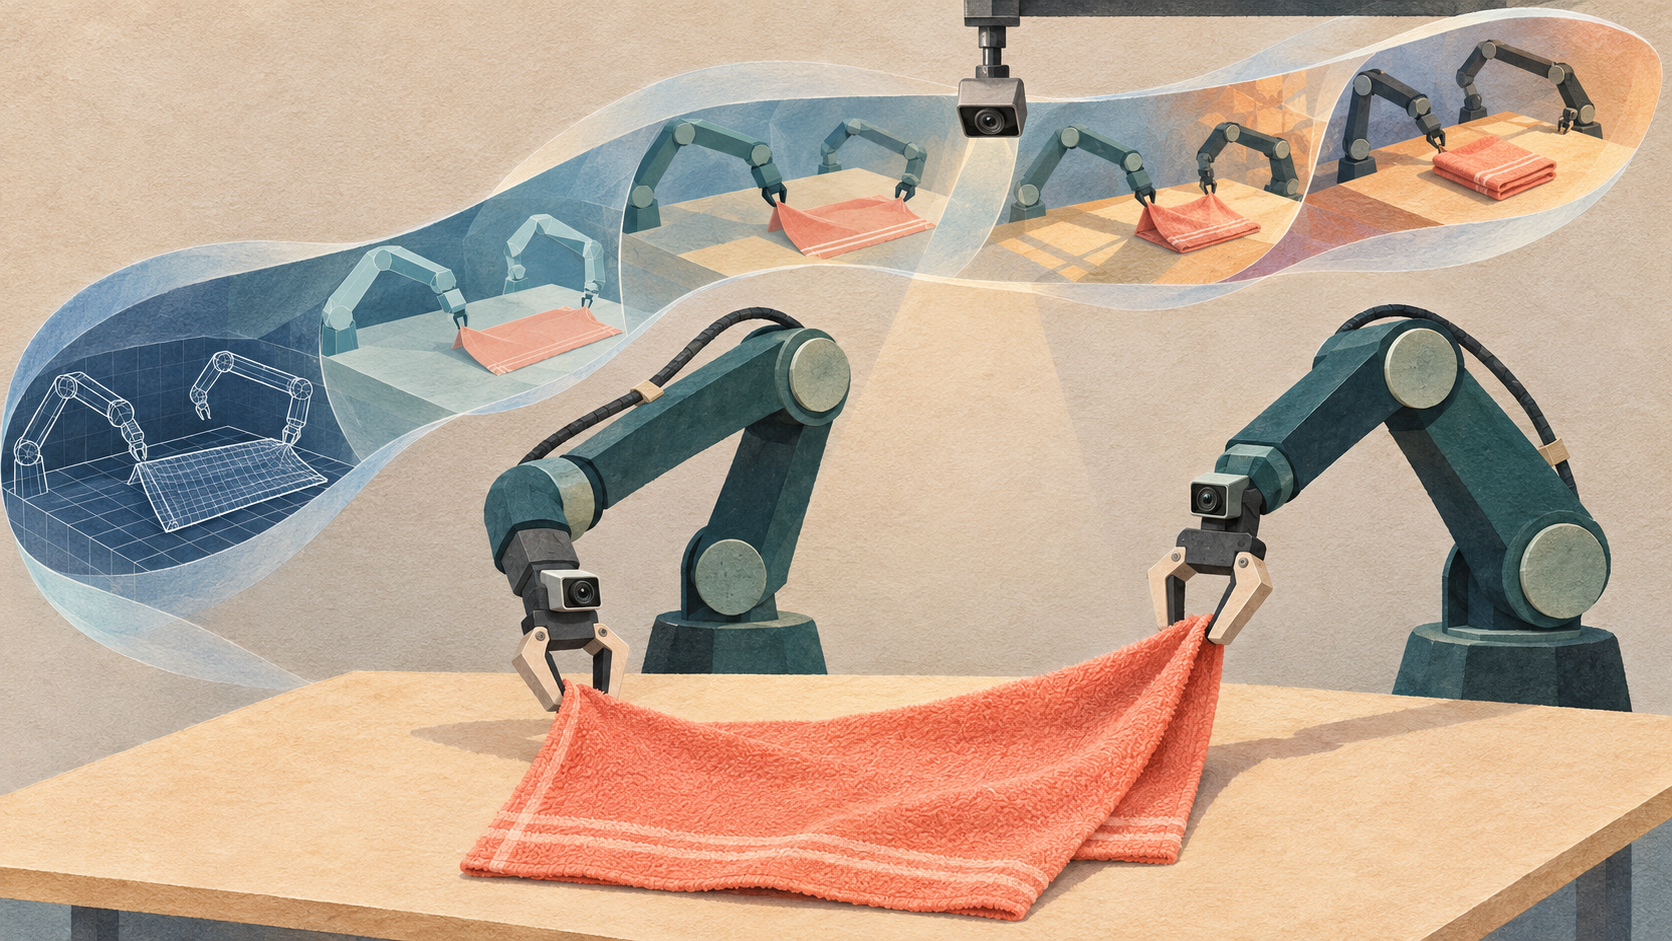
در هدایت انسانی از راه دور، کنشها و تصاویر مستقیماً از ربات ثبت میشوند، اما هر نمایش عملی به گردآوری فیزیکی نیاز دارد. دیتافارم در عوض با شرح وظیفه و یک ضبط واقعی برای کالیبراسیون از یک دوربین روی سر ربات و دو دوربین مچی آغاز میکند. یک عامل برنامهنویس صحنه و دوربینها را بازسازی میکند، کنترلگر میسازد و بررسیهای موفقیت را در شبیهسازی برقرار میکند. ضبط کالیبراسیون مبنای هندسه و ظاهر صحنه است؛ کنشهای آن بهعنوان برچسب آموزشی بازاستفاده نمیشوند.
شبیهساز مسیرهای حرکت و برچسبهای کنش را تولید میکند و مدل ویدئویی با استفاده از تصاویر مرجع واقعی، این مسیرها را بازنمایی میکند. بازنمای پیشفرض، نسخهای از MiniMax-H3 روی زیرساخت خود پژوهشگران است که همه نماهای دوربین را با هم تولید میکند تا سازگاری آنها تقویت شود. نقشهای مجزای عاملها، بررسیهای موفقیت پنهان و بررسیهای خودکار ویدئو، ورود داده به مجموعه را کنترل میکنند. این بازبینها اجزای داخلی سامانهاند، نه ارزیابان بیرونی، و نرخ خطاهای باقیمانده آنها مشخص نشده است.
گروه پژوهشی یک ربات دوبازوی PiPER را در وظایف قرار دادن سه لیوان داخل یکدیگر، گذاشتن سیب روی ترازو، حداقل دو بار ضربه زدن به طبل، گذاشتن مکعب در کشو و بستن آن، و دو بار تا کردن حوله آزمود. برای هر وظیفه، سیاستهای کنترل π0.5 با ۱۰۰ نمونه از هر یک از سه منبع آموزش دیدند: دیتافارم، هدایت واقعی انسانی از راه دور، و بازنمایی شبیهساز با تصادفیسازی دامنه. تنظیمات آموزش یکسان نگه داشته شد. سپس هر سیاست برای هر وظیفه و هر وضعیت، در ۲۰ آزمون فیزیکی ارزیابی شد؛ جایگذاری تصادفی اشیا میان روشها مشترک بود.
در مجموع پنج وظیفه در صحنه اصلی، سیاستهای آموزشدیده با دیتافارم ۹۳ موفقیت از ۱۰۰ آزمون ثبت کردند؛ این تعداد برای هدایت انسانی ۸۴ و برای تصادفیسازی دامنه در شبیهساز ۲۶ بود. با رومیزیهای دیدهنشده و نور رنگی متغیر، مجموع موفقیتها بهترتیب ۸۷، ۴۶ و ۲۱ شد. بنابراین برتری دیتافارم نسبت به هدایت انسانی در صحنه اصلی ۹ واحد درصد و با تغییر ظاهر ۴۱ واحد درصد بود.
این نتایج، فرایندهای کامل آموزش را مقایسه میکنند. ویدئوهای آموزشی دیتافارم شامل تنوع در سطح میز و نور بودند، در حالی که مجموعه هدایت انسانی، صحنه اصلی را نشان میداد. بنابراین نمیتوان مزیت پایداری عملکرد را صرفاً به خودکارسازی با عامل یا بازنمایی ویدئویی نسبت داد. روش مبنای شبیهساز از همان مسیرهای حرکت دیتافارم استفاده میکرد؛ این مقایسه از ارزش فرایند تولید مشاهدات آن پشتیبانی میکند، اما اثرهای شرطیسازی با تصاویر واقعی، تولید ویدئو و افزایش تنوع ظاهری را از هم جدا نمیکند.
نویسندگان میانگین هزینه اولیه سازگار کردن هر وظیفه را ۲۰٫۹۲ دلار و تدوین مشخصات بازنمایی را ۵٫۱۳ دلار گزارش کردهاند؛ پس از آن، هر نمونه پذیرفتهشده ۰٫۸۰ دلار هزینه داشت. با احتساب هزینه اولیه، میانگین هزینه هر نمونه در یک مجموعه ۱۰۰نمونهای ۱٫۰۶ دلار بود. یک ساعت داده همگام سهنما برای هر وظیفه بهطور میانگین ۱۰۷ دلار هزینه داشت؛ در مقایسه با پیشنهاد قیمت ۱۱۷ دلاری برای هدایت انسانی در چین و برآورد ۲۹۰ دلاری صرفاً برای نیروی کار در آمریکای شمالی. مبنای حسابداری این مقایسهها متفاوت است. پوشش هزینه گردآوری کالیبراسیون، زیرساخت و آموزش سیاست روشن نیست، هزینه پایین بازنمایی به اجرای آن روی زیرساخت خود پژوهشگران وابسته است و اجراهای پیشفرض و اجراهای مبنای محاسبه هزینه، از دستورالعملهای متفاوتی برای انتخاب خروجی بازنمایی استفاده کردند.
شواهد همچنان به پنج وظیفه منتخب روی یک پلتفرم رباتیک محدود است. ارزیابی ارائهشده فاصله اطمینان، آزمون آماری یا تکرار آموزش سیاستها را گزارش نمیکند؛ آزمونها درون وظایف و سیاستهای آموزشدیده قرار دارند و تکرارهای مستقل کل فرایند نیستند. بنابراین این شمارشها، همارزی یا برتری همگانی را اثبات نمیکنند. عملکرد همچنین به شبیهسازی مناسب وابسته است: تصادفیسازی جرم یا اصطکاک نامطمئن ممکن است برای وظایف نیازمند دینامیک دقیق کافی نباشد و ویدئوهای تولیدشده میتوانند با وجود بازبینی همچنان نقص داشته باشند. دیتافارم مسیری امیدوارکننده برای داده آموزشی ارزانتر ارائه میدهد، اما آزمون گستردهتر و ارزیابی روی ربات واقعی همچنان ضروری است.
تصویر جلد با هوش مصنوعی تولید شده و تصویرسازی مفهومی است؛ مدرک پژوهش نیست.