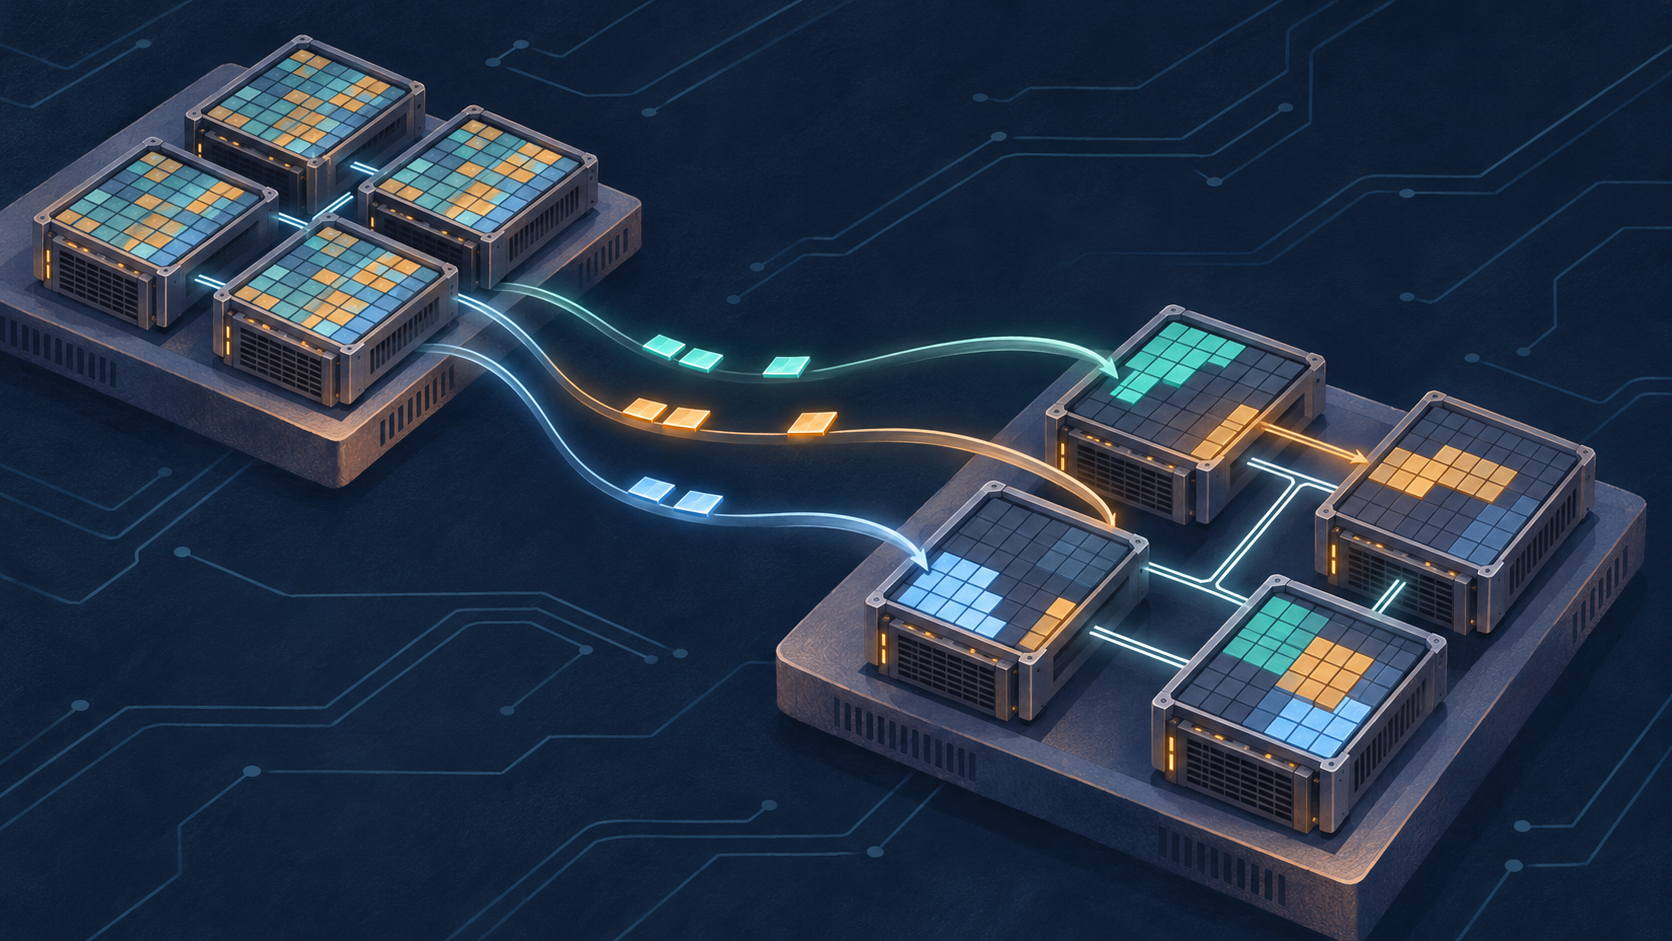
انویدیا از کاهش تأخیر انتقال وزنهای بهروزشده مدل میان پردازندههای گرافیکی آموزش و استنتاج در مرحله پسآموزش با یادگیری تقویتی خبر داده است. این شرکت در مقالهای فنی به قلم نویسندگان خود، منتشرشده در ۶ نوامبر ۲۰۲۶، چهار پیکربندی بنچمارک NeMo RL را شرح داد که در آنها پیادهسازی ترکیبی Reshard نسبت به انتقال متعارف با روش گردآوری و پخش، ۲٫۷ تا ۵٫۷ برابر سریعتر بود.
این انتقال که refit نام دارد، تازهترین وزنهای مدل سیاست را به پردازندههای گرافیکی استنتاج میرساند، در حالی که پردازندههای جداگانه مدل را آموزش میدهند. آموزش و استنتاج ممکن است وزنها را به شکلهای متفاوتی میان پردازندهها تقسیم کنند. روش متعارف refit، قطعههای پارامترها را به تانسورهای کامل تبدیل و آنها را پخش میکند؛ سپس هر مقصد بخش موردنیاز خود را نگه میدارد. این فرایند ممکن است دادههایی را منتقل کند که مقصد به آنها نیازی ندارد.
Reshard در عوض، چیدمان مبدأ و مقصد را با انتزاع تانسور توزیعشده PyTorch یا DTensor نمایش میدهد. پیادهسازی NCCL M2N آن، همپوشانی قطعهها را محاسبه و نواحی موردنیاز را منتقل میکند. همچنین نسخههای تکراری مقصد را بر اساس دامنه NVLink گروهبندی میکند، دادههای ورودی را میان آنها تقسیم میکند و با تبادل محلی از طریق NVLink، وزنهای آنها را تکمیل میکند؛ در نتیجه انتقالهای تکراری شبکه کاهش مییابد. انویدیا پیادهسازی مرجع را در مخزن متنباز nccl-extensions ارائه کرده است.
پیادهسازی سنجیدهشده در NeMo RL ترکیبی است: برای وزنهای نگاشت پیشخور از Reshard استفاده میکند؛ وزنهایی که به گفته انویدیا حدود ۹۵ درصد پارامترهای جدیدترین مدلهای زبانی بزرگ را تشکیل میدهند. برای سایر وزنها، روش گردآوری و پخش حفظ شده است. این رویکرد تفاوتهای عملی در نحوه تقسیم انواع لایهها توسط موتورهای مختلف را پوشش میدهد.
در DGX H100، تأخیر refit برای Qwen 3 235B از ۶٫۴ به ۱٫۹ ثانیه کاهش یافت؛ یعنی حدود ۳٫۴ برابر سریعتر شد. برای DeepSeek v3 671B، این زمان در H100 از ۱۴٫۹ به ۲٫۶ ثانیه، معادل حدود ۵٫۷ برابر افزایش سرعت، و در DGX GB200 از ۶٫۱ به ۲٫۳ ثانیه، معادل حدود ۲٫۷ برابر افزایش سرعت، رسید. برای Nemotron Ultra v3 در GB200، زمان از ۸٫۲ به ۲٫۳ ثانیه کاهش یافت؛ یعنی حدود ۳٫۶ برابر سریعتر شد. هر مقایسه از ترکیب مشخصی از مدل، سختافزار و چیدمانهای موازیسازی آموزش و استنتاج استفاده کرده بود.
یک ریزبنچمارک جداگانه که فقط refit را میسنجید، برای Qwen3.8 2.4T با وزنهای BF16 زمان ۴٫۳ ثانیه را گزارش کرد. مقاله برای این نتیجه، زمان مبنای مقایسه، پلتفرم سختافزاری یا چیدمان موازیسازی ارائه نکرد. مثالهای حدود ۱۰ ترابایتی آن برای refit متعارف نیز برآورد حجم منطقی داده بر پایه وزنهای BF16 و دو مرحله ارتباطیاند، نه اندازهگیری ترافیک واقعی شبکه.
یافتهها از refit سریعتر در پیکربندیهای آزمایششده پشتیبانی میکنند، اما بهبود معادل در زمان کل آموزش با یادگیری تقویتی یا کیفیت مدل را اثبات نمیکنند. تنها چهار پیکربندی مقایسهای ارائه شده و عملکرد گستردهتر در سختافزارها، چیدمانها و حالتهای دقت عددی دیگر هنوز مشخص نشده است. تعداد تکرارهای زمانسنجی، تغییرپذیری نتایج، فاصلههای اطمینان، مراحل آمادهسازی پیش از اندازهگیری، نسخههای نرمافزار و تنظیمات تفصیلی شبکه گزارش نشدهاند. منبع ارائهشده شامل تکرار مستقل آزمایش نیست و داوری همتا را نیز احراز نمیکند. بهبودهای گزارششده مربوط به پیادهسازی ترکیبیاند، نه اجرای Reshard روی تکتک پارامترها.
منبع: NVIDIA Developer، ۶ نوامبر ۲۰۲۶. https://developer.nvidia.com/blog/accelerating-reinforcement-learning-weight-refit-with-the-reshard-collective
تصویر جلد با هوش مصنوعی تولید شده و تصویرسازی مفهومی است؛ مدرک پژوهش نیست.